Cuprins
Când un agent AI primește o vulnerabilitate de reparat, cea mai simplă verificare este dacă programul mai cade la intrarea care a declanșat problema. Un studiu al cercetătorilor de la Northwestern University arată că această verificare spune prea puțin: un patch poate face crash-ul să dispară fără să repare comportamentul pe care îl așteaptă dezvoltatorii proiectului.
Lucrarea On the Reliability of LLM-Based Vulnerability Patching Benchmarks, semnată de Dang K Le, Wenxuan Shi și Xinyu Xing, a fost depusă pe arXiv pe 7 octombrie 2026 și prezentată pe 12 octombrie de Help Net Security. Ea compară, pe aceleași cazuri, două feluri de a nota un agent: după dispariția crash-ului și după testele scrise de dezvoltatorii proiectelor.
Ce au testat cercetătorii
Autorii au construit un set de 112 erori de securitate reale, din 84 de proiecte open source: 25 de cazuri în C/C++ (10 proiecte), 62 în Go (51 de proiecte) și 25 în Rust (23 de proiecte). Cazurile provin din issue-uri GitHub, GitHub Security Advisories, avertismentele RUSTSEC și istoricul de commit-uri.
Fiecare patch propus de agent trece prin trei verificări:
| Verificare | Întrebarea la care răspunde |
|---|---|
| Testul de crash (PoC) | Mai produce crash intrarea cunoscută? Intrarea este rulată de zece ori. |
| Testele de regresie | Trec în continuare testele existente ale proiectului? |
| Testul dezvoltatorilor | Se comportă patch-ul cum au intenționat dezvoltatorii, pe intrări apropiate de bug? Testul e extras din commit-ul reparației oficiale. |
Agentul folosit în experimentul principal a fost OpenCode, cu modele Claude, rulat în containere Docker, fără acces la rețea în configurația implicită și cu un buget de 30 de minute și 500 de pași pentru fiecare caz. Un caz a intrat în set doar dacă reparația oficială trece toate cele trei verificări. Sursa: lucrarea, secțiunile 4.1–4.4 și anexa A.
Crash-ul dispare mai des decât se repară eroarea
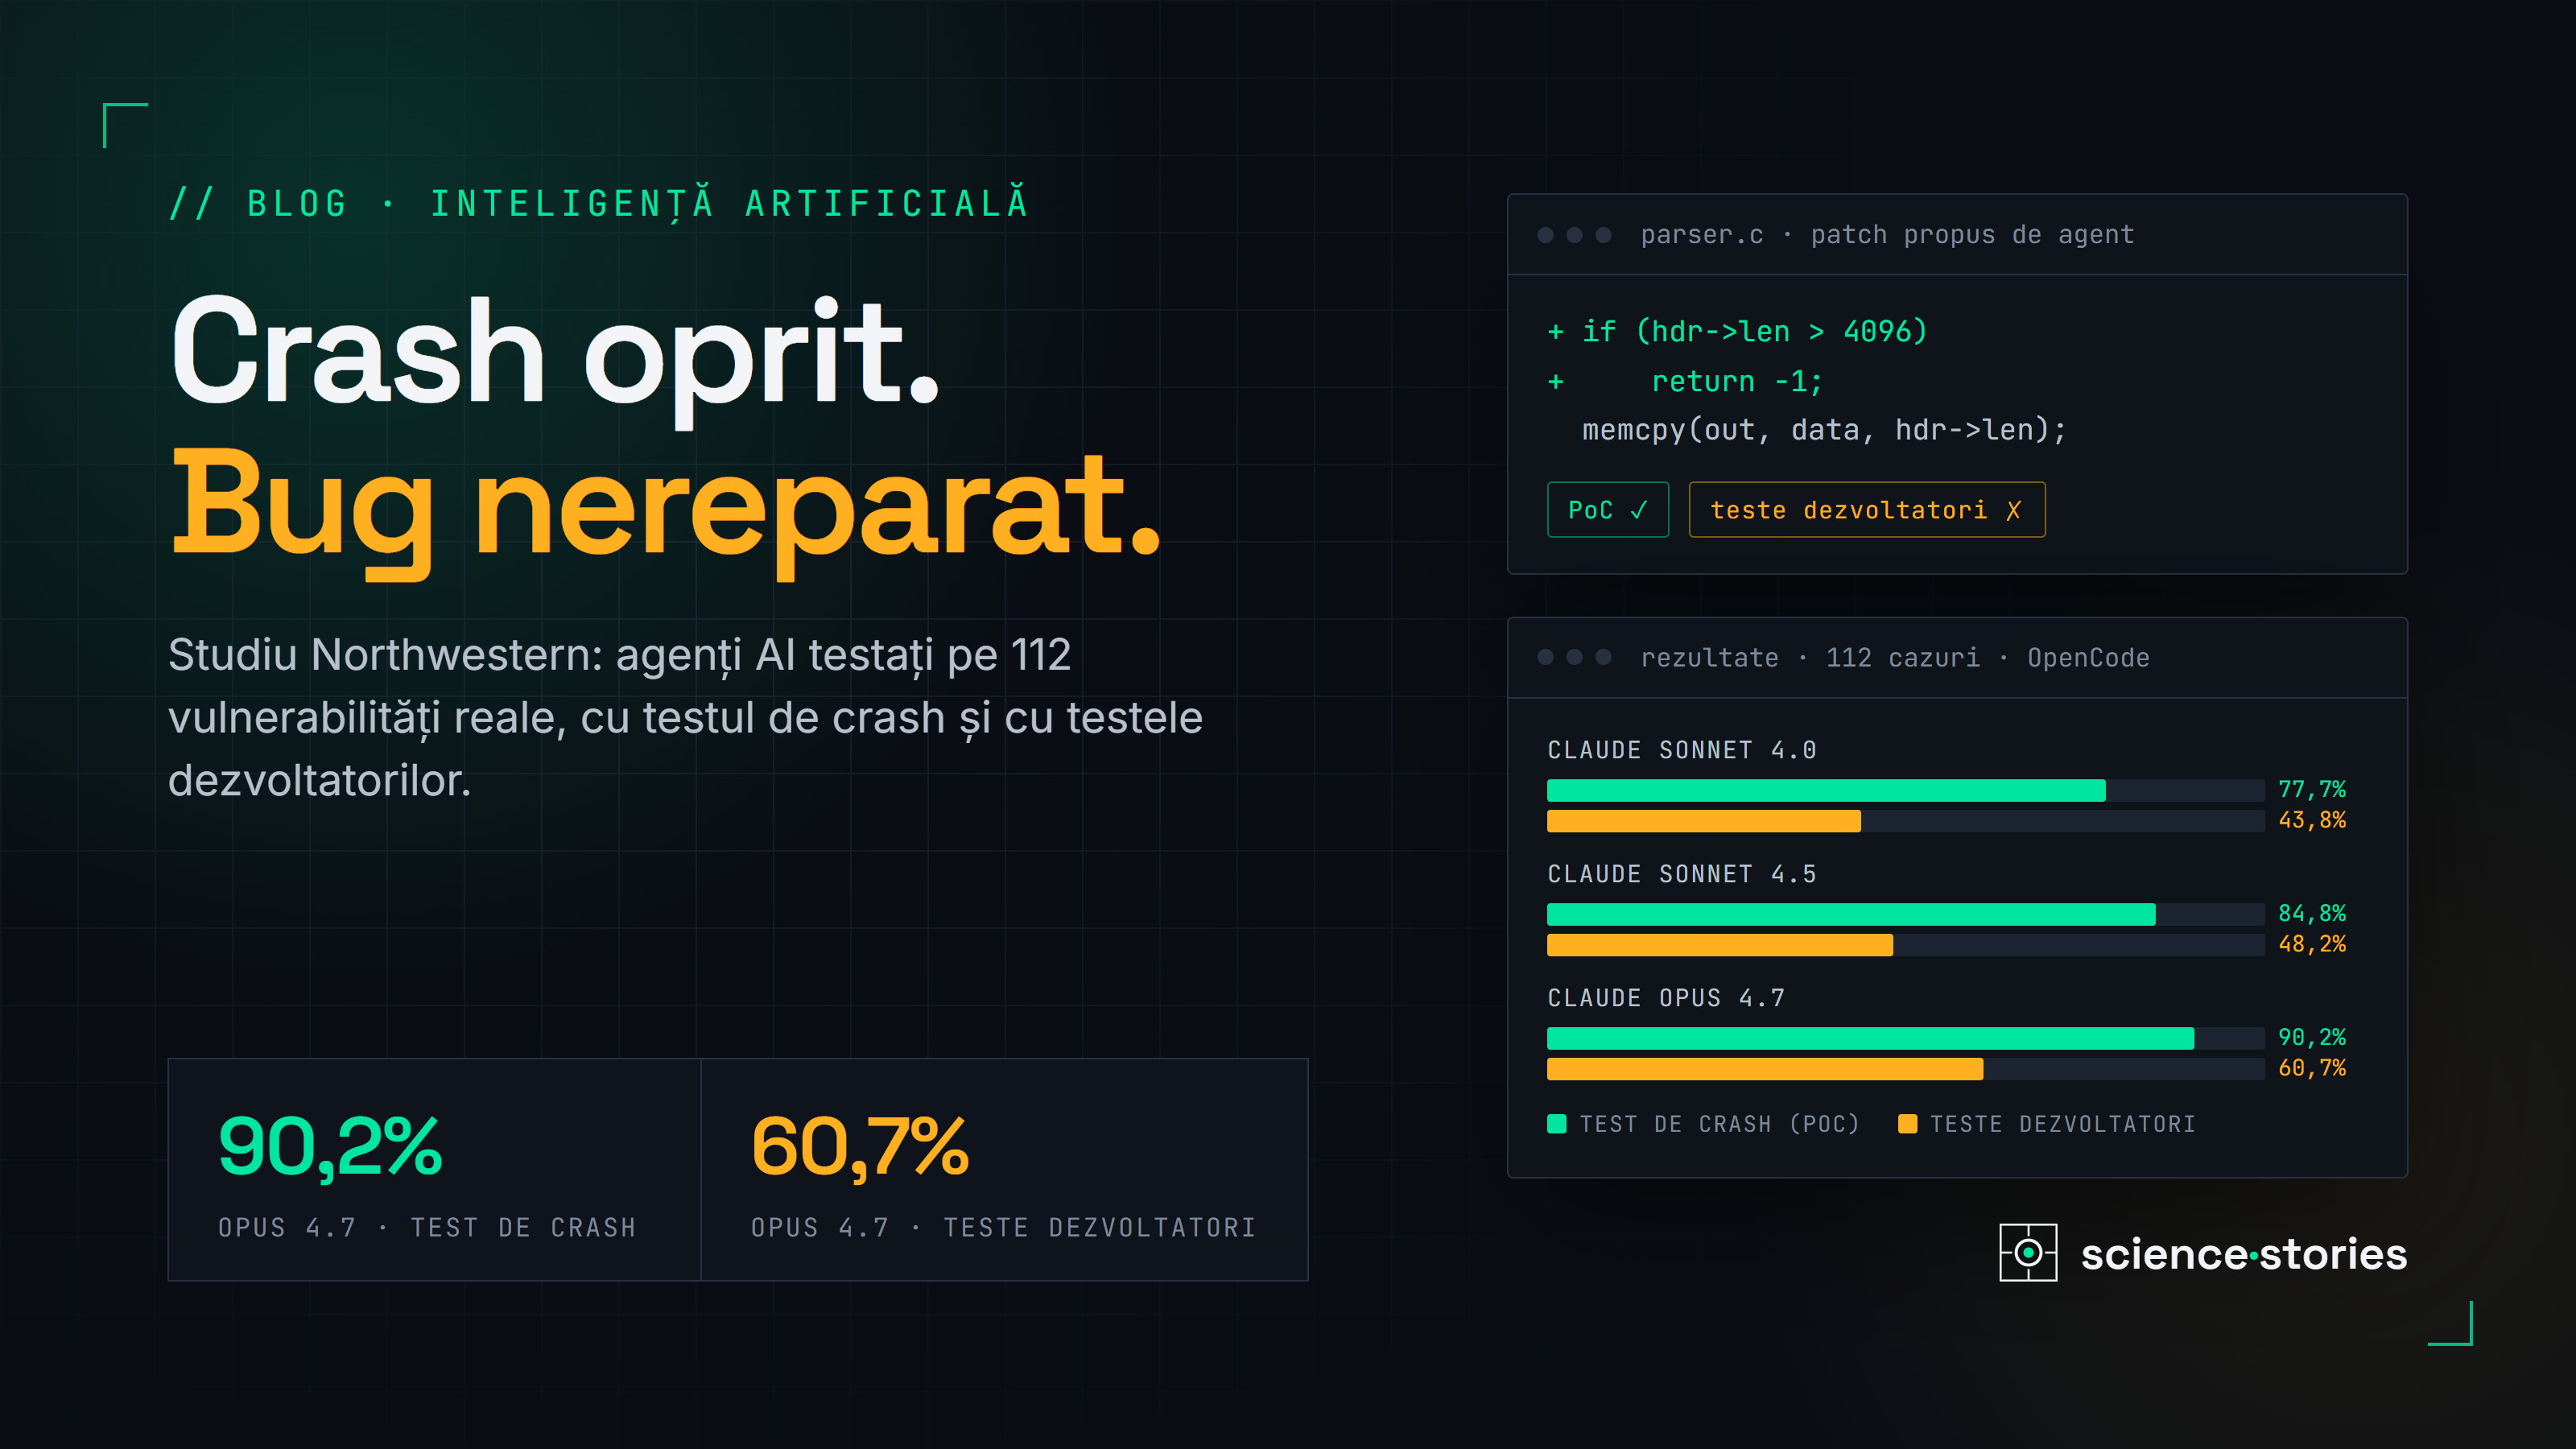
Tabelul 4 din lucrare raportează, pentru toate cele 112 cazuri:
| Model (prin OpenCode) | Testul de crash (PoC) | Testele de regresie | Testele dezvoltatorilor |
|---|---|---|---|
| Claude Sonnet 4.0 | 77,7% | 97,3% | 43,8% |
| Claude Sonnet 4.5 | 84,8% | 94,6% | 48,2% |
| Claude Opus 4.7 | 90,2% | 94,6% | 60,7% |
Pentru Claude Opus 4.7, 32,7% dintre cazurile care trec testul de crash pică testul dezvoltatorilor, iar distanța dintre cele două rate este de 29,5 puncte procentuale. Procentele se referă la cazuri, nu la patch-uri individuale.
Ambele rate cresc de la un model la altul, dar distanța dintre ele rămâne mare: 33,9, 36,6 și 29,5 puncte procentuale. Autorii trag concluzia că modelele au progresat mai repede la suprimarea simptomelor decât la patch-uri care trec testele scrise de dezvoltatori.
Lucrarea mai arată cât de ușor se poate umfla scorul măsurat doar prin crash. În experimentul 2, cu Claude Sonnet 4.0, cazurile Go în care agentul a primit și sursa testului PoC au urcat la testul de crash de la 69,4% la 95,2%. La testele dezvoltatorilor au urcat doar de la 41,9% la 48,4%. Scorul a crescut mai ales la verificarea pe care agentul o putea vedea.
De ce contează diferența? Autorii o spun direct: o reparație care reduce la tăcere PoC-ul, dar strică un colț al funcționalității, este „strict mai rea decât lipsa oricărei reparații”. Vulnerabilitatea apare ca rezolvată, iar problema rămasă ajunge în producție fără ca cineva să o mai caute. Sursa: lucrarea, secțiunile 2.2, 5.2 și 5.3.
Un exemplu: același crash, două reparații
Exemplul următor este ipotetic, dar ilustrează mecanismul din studiu. O funcție C copiază datele unui mesaj în care expeditorul declară lungimea în antet:
#include <stdint.h>
#include <string.h>

struct header {
    size_t len;  /* lungimea declarată de expeditor */
};

int parse_message(const struct header *hdr, const uint8_t *data, size_t data_size,
                  uint8_t *out, size_t out_size)
{
    memcpy(out, data, hdr->len);  /* hdr->len nu este verificat */
    return 0;
}
Intrarea PoC declară len = 5000, iar buffer-ul out are 4096 de octeți, deci programul cade. Un patch care urmărește doar crash-ul limitează lungimea la valoarea din PoC:
    if (hdr->len > 4096) {
        return -1;  /* PoC-ul nu mai produce crash */
    }
    memcpy(out, data, hdr->len);
Testul de crash trece. Un mesaj care declară însă 100 de octeți și conține doar 10 citește în continuare dincolo de data. Cauza reală este că lungimea declarată nu e comparată cu datele primite și cu buffer-ul de destinație:
    if (hdr->len > data_size || hdr->len > out_size) {
        return -1;
    }
    memcpy(out, data, hdr->len);
Testele scrise de dezvoltatori verifică tocmai astfel de intrări vecine bug-ului. Primul test de mai jos pică pentru patch-ul simptomatic, nu și pentru reparația completă:
uint8_t data[10] = {0};
uint8_t out[4096];

/* Lungimea declarată depășește datele primite: mesajul trebuie respins. */
assert(parse_message(&(struct header){ .len = 100 }, data, sizeof data, out, sizeof out) == -1);

/* Mesaj valid: trebuie acceptat. */
assert(parse_message(&(struct header){ .len = 10 }, data, sizeof data, out, sizeof out) == 0);
Benchmark-urile au și ele probleme
Partea cea mai amplă a lucrării analizează felul în care sunt construite evaluările. Autorii descriu nouă capcane, grupate pe trei niveluri, și compară cu ele 13 benchmark-uri și seturi de date, printre care SWE-bench, SEC-bench și ARVO:
- La nivelul agentului: instrucțiunile de build și test din prompt și accesul la internet.
- La nivelul platformei de evaluare: permisiunile configurate greșit, timeout-urile și mecanismele ascunse ale agenților, testele scrise de agent care intră în conflict cu cele ale dezvoltatorilor.
- La nivelul setului de date: verificarea doar prin PoC, formatul PoC-ului, proveniența cazurilor (cu riscul ca reparațiile să fie deja cunoscute de model) și echilibrul între limbaje.
Studiile de caz arată cum un agent poate ajunge la reparația oficială fără să o găsească singur:
- Prin căutare pe web. Cu acces la internet, agentul a descărcat patch-ul oficial al proiectului xz.
- Prin istoricul git. În cazul bibliotecii bluemonday, o căutare în
git logdupă numărul issue-ului a găsit commit-ul cu reparația. Autorii precizează că folosirea istoricului nu e rău intenționată. Problema este că scorul nu mai separă priceperea agentului de informația pe care a găsit-o deja. Despre lucrul cu istoricul unui proiect găsești mai multe în cursul GIT pentru ingineri electroniști. - Printr-un fișier de configurare. Într-un caz PHP, agentul a citit un fișier care indica patch-ul oficial, iar modificările lui au fost identice cu acesta.
Unele eșecuri nu au ținut deloc de model. În configurația autorilor, modelele treceau printr-un proxy LiteLLM, iar Claude Code trimitea fiecare comandă Bash la o verificare de siguranță către un model pe care proxy-ul nu îl ruta. Fiecare apel aștepta aproximativ 120 de secunde, ceea ce semăna cu un model care se chinuie. Într-un alt caz, din framework-ul Fiber, reparația agentului era echivalentă funcțional cu cea oficială, dar modifica fișierul de test. Testul dezvoltatorilor nu s-a mai putut aplica, iar cazul a fost numărat ca eșec.
Într-o rulare completă, astfel de factori întâmplători au afectat între aproximativ 5% (permisiunile) și 32% (conflictele cu testele) din cazuri. Sursa: lucrarea, secțiunile 3 și 6.
Ce înseamnă pentru cine folosește agenți la reparații de securitate
- Nu accepta „crash-ul a dispărut” ca dovadă. Rulează testele existente și adaugă teste pentru intrările vecine bug-ului: valori la limita buffer-elor, lungimi declarate greșit, câmpuri goale.
- Cere cauza, nu doar patch-ul. Agentul trebuie să explice ce invariant era încălcat și de ce modificarea îl restabilește. O condiție pusă exact la locul crash-ului merită o a doua privire.
- Raportează separat rezultatele. Când compari agenți sau produse, notează distinct testul de crash, testele de regresie și testele dezvoltatorilor.
- Află ce informații a avut agentul. Un scor bun obținut cu acces la internet, la istoricul git sau la fișiere care indică reparația oficială nu spune cum se va descurca agentul pe o vulnerabilitate nouă.
Help Net Security rezumă recomandarea în patru întrebări pentru furnizorii de astfel de instrumente:
- Scorul include testele scrise de mentenanții proiectelor?
- Agentul a avut acces la internet sau la istoricul git?
- Ce instrucțiuni de build și test a primit în prompt?
- Cum au fost numărate timeout-urile și erorile platformei de evaluare?
Același principiu se aplică oricărei schimbări în felul în care lucrează un agent: o măsori pe sarcini fixe și cu verificări independente. Am discutat un astfel de protocol în articolul Agenți AI mai eficienți prin reguli explicite și gestionarea contextului.
Limitele studiului
- Este un preprint. Pagina arXiv nu indică o publicare evaluată de colegi la data consultării, deci rezultatele trebuie tratate ca preliminare. Lucrarea pe arXiv.
- Setul e mic și selectat. 112 cazuri pot favoriza proiectele bine întreținute, iar autorii nu susțin că procentele absolute se generalizează.
- Testele dezvoltatorilor nu sunt un etalon perfect. O reparație corectă, dar diferită de cea oficială, poate pica, cum s-a întâmplat în cazul Fiber.
- Rezultatele depind de configurație. Experimentul principal a folosit doar modele Claude prin OpenCode, iar rezultatele variază cu agentul, cu modelul și de la o rulare la alta.
- Memorarea nu poate fi exclusă. Reparațiile istorice pot apărea în datele de antrenare ale modelelor. Autorii argumentează că acest lucru nu explică rezultatele principale.
Concluzia practică rămâne valabilă indiferent de procente: o vulnerabilitate e reparată când trec testele care descriu comportamentul corect, nu când dispare simptomul. Dacă lucrezi în Rust, unul dintre cele trei limbaje din studiu, poți continua cu cursul Rust.