Cuprins
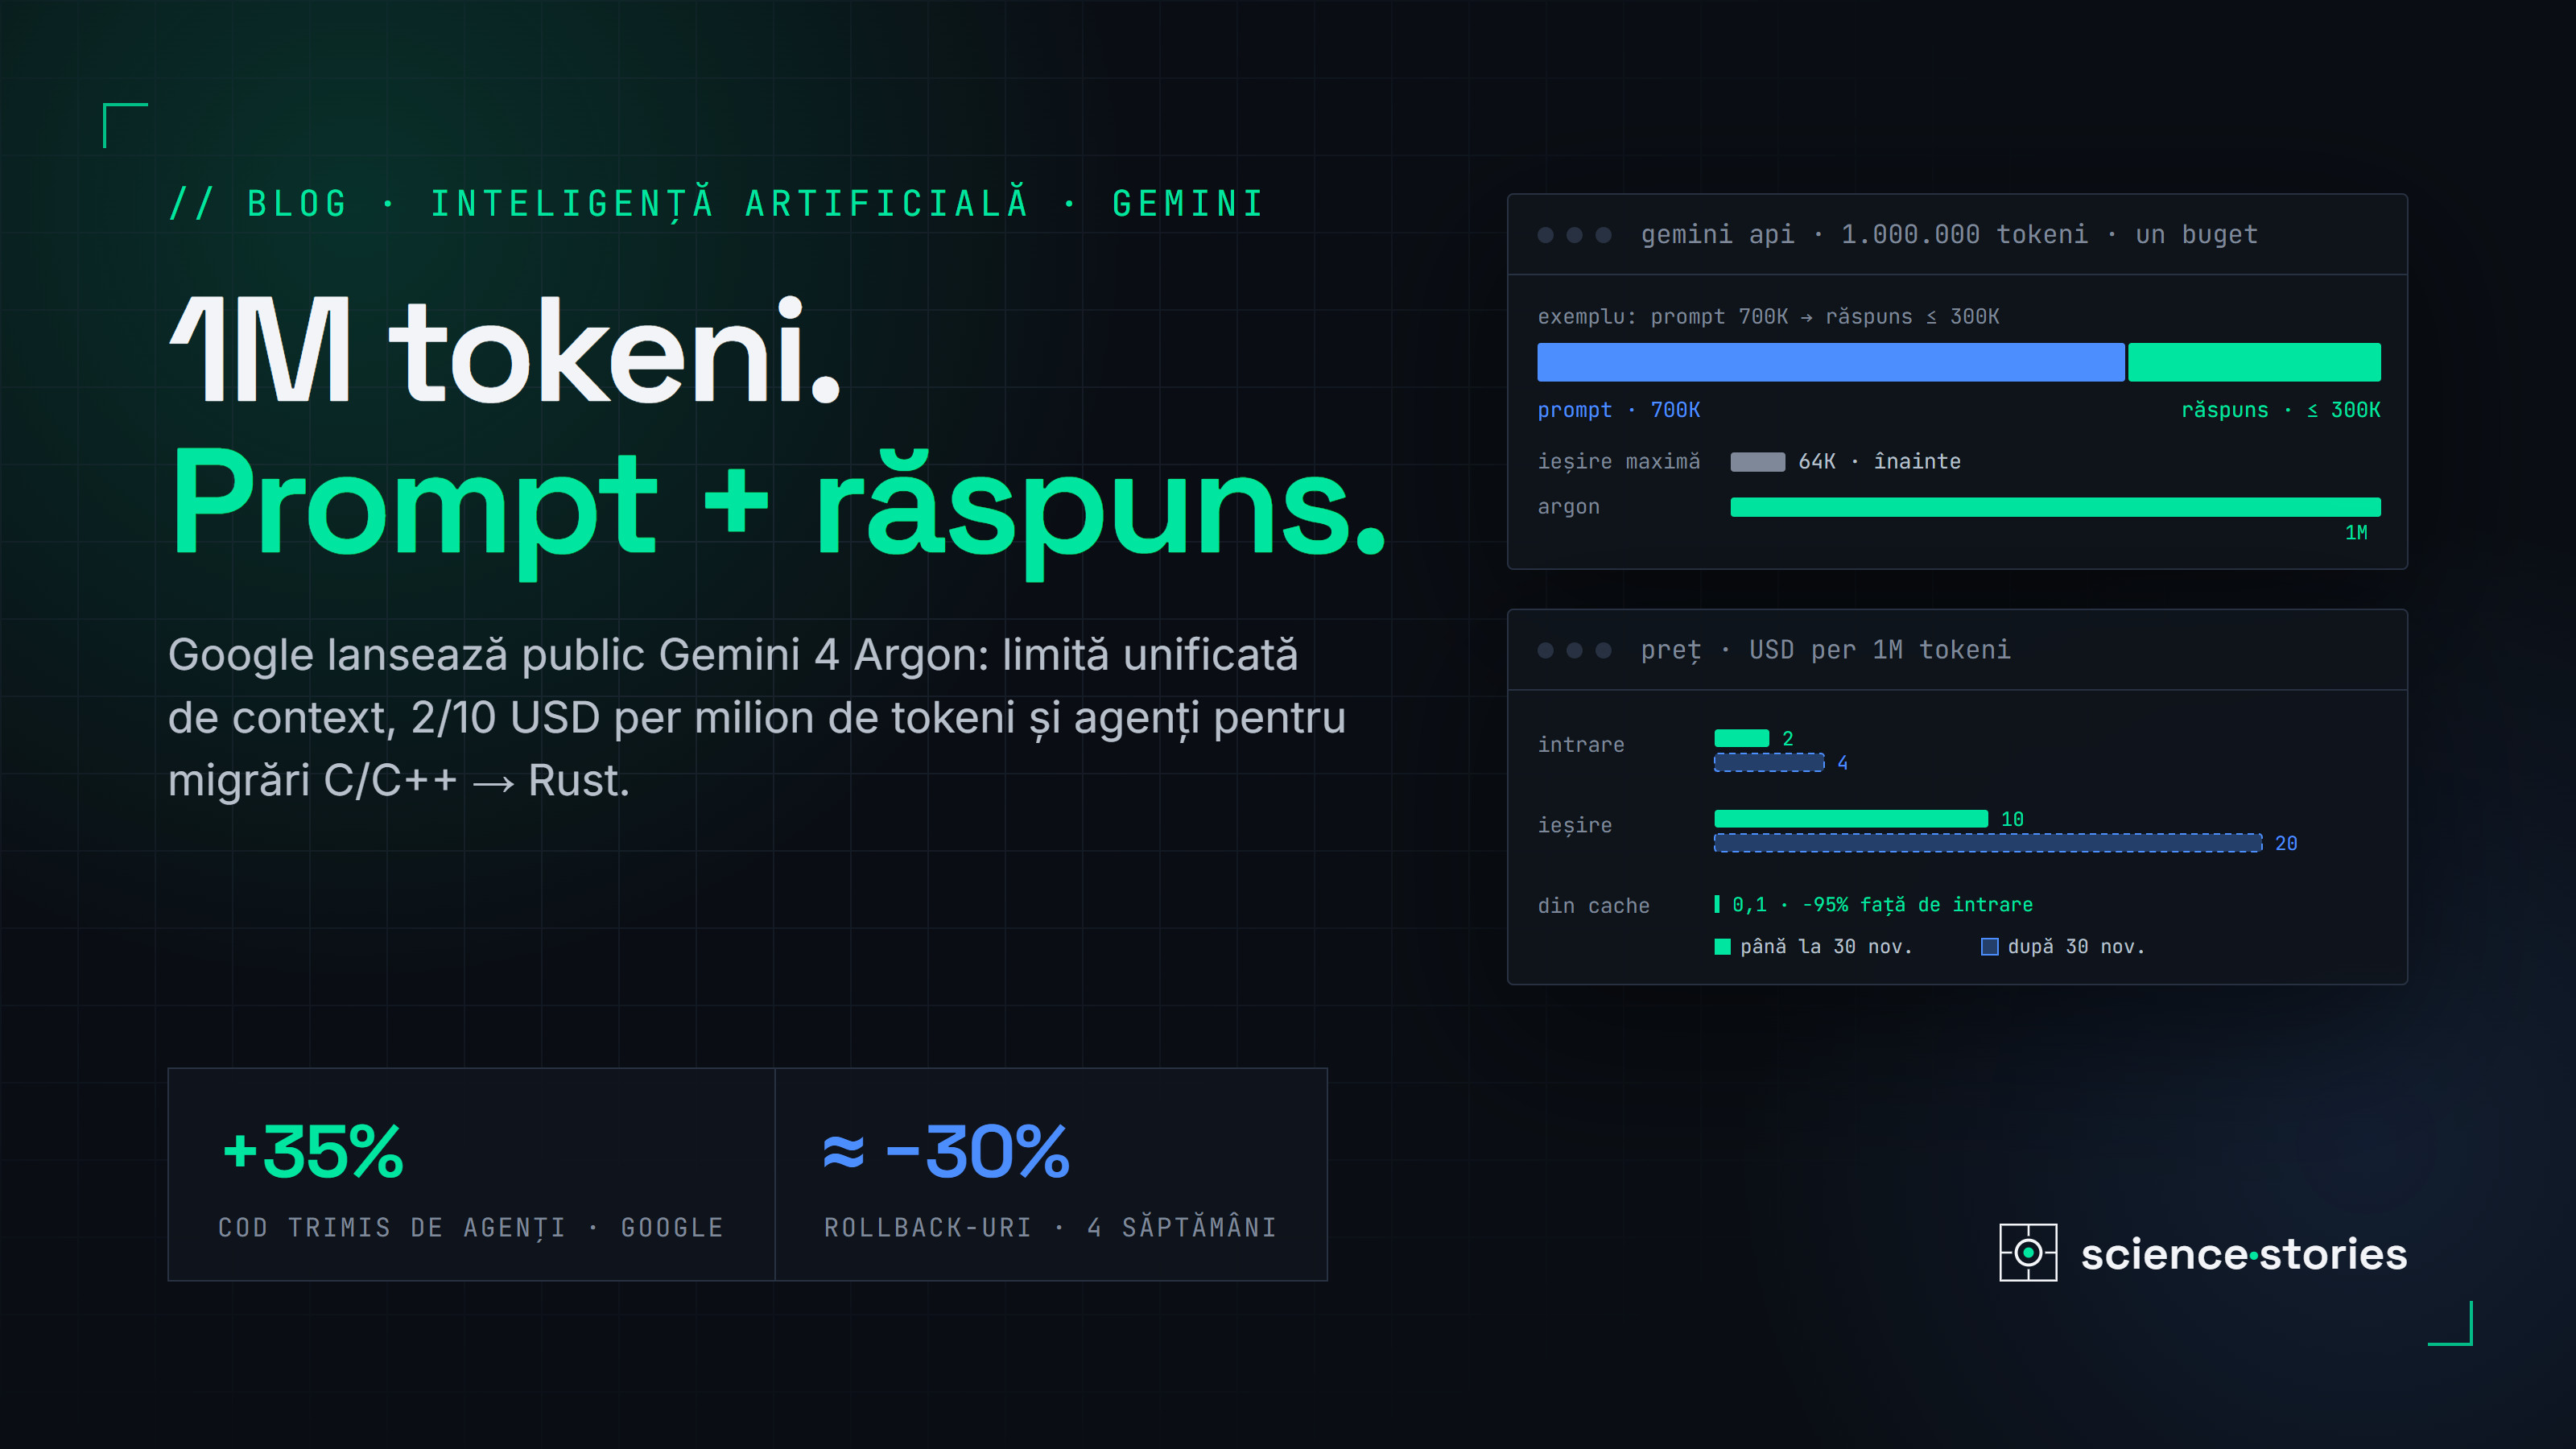
Pe 13 octombrie 2026, Google a făcut Gemini 4 Argon disponibil public pentru dezvoltatori și companii: prin Gemini API, în Google AI Studio și în Google Antigravity, platforma sa de dezvoltare cu agenți. Modelul are o limită unificată de 1 milion de tokeni pentru prompt și răspuns împreună și un preț introductiv de 2 USD per milion de tokeni de intrare și 10 USD per milion de tokeni de ieșire. Google îl prezintă ca model pentru lucrări lungi: migrări de cod, optimizări și sarcini agentice care durează ore. Sursa: anunțul Google.
Argon nu este complet nou. Google l-a anunțat pe 30 septembrie și l-a dat atunci doar unui grup de specialiști în securitate cibernetică, prin programul Fairwind. Articolul verifică cifrele lansării publice, explică ce înseamnă limita de 1 milion de tokeni pentru costuri și notează ce lipsește din anunț.
Cifrele principale
| Parametru | Valoare |
|---|---|
| Lansare publică | 13 octombrie 2026 (anunțat pe 30 septembrie, pentru programul Fairwind) |
| Gemini API | doar nivelul plătit, în AI Studio și Android Studio |
| Google Antigravity | aplicația desktop și CLI, pentru abonații Google AI Ultra și abonamentele Gemini Enterprise eligibile |
| Aplicația Gemini, AI Mode | pentru abonații Google AI Ultra și Pro |
| Limită de tokeni (Gemini API) | 1 milion, unificată pentru intrare și ieșire |
| Ieșire maximă | până la 1 milion de tokeni, față de 64 000 la modelele anterioare |
| Preț introductiv | 2 USD / 1M tokeni de intrare, 10 USD / 1M tokeni de ieșire |
| Intrare din cache | cu 95% mai ieftină decât intrarea normală |
| Preț după 30 noiembrie 2026 | 4 USD / 1M tokeni de intrare, 20 USD / 1M tokeni de ieșire |
| DeepSWE v1.1 | 77,9%, cel mai bun rezultat raportat (date Google) |
Valorile sunt din anunțul din 13 octombrie, din cel din 30 septembrie și din postarea pentru dezvoltatori. Google nu publică în aceste texte limitele de rată și nici prețul intrării din cache după perioada introductivă.
Verificarea afirmațiilor
- „Lansat pe 13 octombrie prin API, AI Studio și Antigravity”. Confirmat, cu două precizări. În API, modelul este disponibil doar pe nivelul plătit. În Antigravity, doar pentru abonații Google AI Ultra și pentru unele abonamente Gemini Enterprise.
- „Limită combinată de 1 milion de tokeni”. Confirmat. Formularea Google este „limită unificată de 1M tokeni pentru intrare și ieșire prin Gemini API”. Pe 30 septembrie, Google vorbea despre o limită de ieșire de 1M tokeni, de la 64 000 înainte. Cele două formulări nu se contrazic dacă limita este un buget comun: tot ce intră în prompt se scade din ce poate genera modelul.
- „Preț introductiv de 2/10 USD per milion de tokeni”. Confirmat. Perioada introductivă se încheie pe 30 noiembrie 2026, apoi prețul se dublează, la 4/20 USD.
- „Rezultate importante în migrări C/C++ → Rust”. Confirmat, dar cifrele sunt în anunțul din 30 septembrie, nu în cel din 13 octombrie. Detalii mai jos.
- „Optimizarea codului”. Confirmat, cu exemple concrete: Chromium, ADK, vLLM, xTB.
- „35% mai multe modificări de cod trimise de agenți și aproape o treime mai puține rollback-uri în testele interne”. Parțial corect. Cifrele nu vin din teste, ci din utilizarea internă la Google, pe o perioadă de patru săptămâni. Formulările diferă și ele: anunțul spune „peste 35%” și „aproape o treime”, iar blogul Antigravity spune „35%” și „30% mai puține rollback-uri după submit”.
Rezumatul este corect în linii mari. Singura formulare de corectat este „testele interne”: este vorba de o măsurătoare din producția Google, fără grup de control publicat.
Ce înseamnă 1 milion de tokeni unificați
Un token este unitatea în care modelul citește și scrie text: o bucată de cuvânt, un cuvânt scurt sau un semn de punctuație. Fereastra de context este numărul maxim de tokeni pe care modelul îi poate „vedea” într-o singură cerere. La Argon, prin Gemini API, în acest milion intră și promptul (instrucțiuni, fișiere, istoricul conversației), și răspunsul generat.
Ca ordin de mărime, o linie de cod are de obicei câteva până la câteva zeci de tokeni. Un milion de tokeni înseamnă deci zeci de mii de linii de cod, poate o sută de mii, în funcție de limbaj și stil. Estimarea este a noastră. Pentru cele mai multe biblioteci este suficient, dar un proiect mare nu încape întreg. Migrarea kernelului Zircon din Fuchsia, de exemplu, cuprinde peste 800 000 de linii. O migrare de această mărime nu se face într-o singură cerere, ci de agenți care lucrează pe bucăți și verifică fiecare bucată.
Limita unificată are o consecință practică. Dacă trimiți un prompt de 700 000 de tokeni, răspunsul poate avea cel mult 300 000. Un răspuns de un milion de tokeni este posibil doar cu un prompt aproape gol. Pentru generările foarte lungi, Google menționează un protocol de continuare nou, descris în documentația pentru dezvoltatori.
Cât costă o sesiune lungă
Costul unei cereri se calculează din tokenii de intrare, tokenii de intrare luați din cache și tokenii de ieșire:
unde prețurile p sunt în USD per milion de tokeni. La prețul introductiv, p_{in} = 2, p_{out} = 10, iar p_{cache} = 0{,}1, adică 95% reducere.
Exemplu ipotetic: un agent lucrează 50 de ture pe un proiect. La fiecare tură retrimite un context de 400 000 de tokeni și generează 4 000 de tokeni.
| Scenariu | Intrare (20 M tokeni) | Ieșire (0,2 M tokeni) | Cost total |
|---|---|---|---|
| Fără cache, preț introductiv | 20 × 2 = 40 USD | 0,2 × 10 = 2 USD | 42 USD |
| Cu cache, preț introductiv | 20 × 0,1 = 2 USD | 0,2 × 10 = 2 USD | 4 USD |
| Fără cache, după 30 noiembrie | 20 × 4 = 80 USD | 0,2 × 20 = 4 USD | 84 USD |
Calculul este al nostru și simplifică: presupune că tot contextul retrimis vine din cache, fără prima citire și fără eventuale costuri de stocare a cache-ului, pe care anunțul nu le menționează. Concluzia rămâne: la un agent care lucrează pe contexte mari, cache-ul contează mai mult decât prețul de listă, iar ieșirea devine partea scumpă abia când modelul scrie mult cod.
Migrări C/C++ → Rust
Anunțul din 30 septembrie descrie cea mai interesantă parte pentru programatori: agenți bazați pe Argon care mută cod C/C++ în Rust, în proiecte Google. Scara merge de la zeci de mii de linii, în biblioteci ca re2 (expresii regulate) și libgav1 (decodor video AV1), până la peste 800 000 de linii în kernelul Zircon al sistemului Fuchsia.
Motivul este siguranța memoriei. În C și C++, erori ca citirea în afara unui buffer sau folosirea unei zone de memorie deja eliberate trec de compilator și ajung în producție, unde devin vulnerabilități. Rust interzice aceste erori la compilare, prin regulile de ownership și borrowing. Rescrierea de mână a unui kernel sau a unui decodor video este însă o muncă de ani, iar aici Google folosește agenți.
Cel mai concret exemplu este libgav1. Agenții au înlocuit 32 000 de linii de cod SIMD dintr-un port Rust existent al decodorului. Codul SIMD folosește instrucțiuni vectoriale ale procesorului, care prelucrează mai multe valori deodată. Rezultatul rulează de 2,7 ori mai repede decât portul Rust anterior, cu ieșire video identică. Comparația este cu portul Rust, nu cu originalul C++: Google spune doar că noul cod se apropie de varianta C++ optimizată.
„Ieșire video identică” este și metoda de verificare care contează. Un decodor se poate testa bit cu bit: același fișier de intrare trebuie să producă exact aceleași cadre. Google adaugă că rescrierile trec prin audit automat și manual, teste în emulare și review înainte de producție. Este aceeași lecție ca în studiul despre agenții AI care opresc crash-ul fără să repare vulnerabilitatea: un agent este util doar dacă rezultatul lui poate fi verificat independent.
Blogul Antigravity adaugă un al doilea caz: un cod Fortran rescris complet în Rust, de 1,8 ori mai rapid și sigur din punctul de vedere al memoriei. Dacă vrei să înțelegi regulile care fac Rust sigur, ele sunt explicate în cursul Rust.
Optimizarea codului
Anunțul din 13 octombrie enumeră mai multe optimizări făcute cu Argon în proiecte Google și partenere:
| Proiect | Ce a făcut Argon | Rezultat declarat |
|---|---|---|
| Chromium (40 mil. linii) | a separat procesarea de bază a paginilor dintr-un folder vechi de ~6 mil. linii | sute de fișiere, „luni de muncă în săptămâni” |
| ADK (Python) | a lucrat autonom peste noapte | −40% timp de pregătire a sesiunilor lungi, −21% la importurile la rece |
| Gemma 4 E2B pe vLLM, A100 | optimizarea inferenței | de 2,85 ori mai rapid: de la ~37 900 la peste 108 000 tokeni/s, cu ieșire identică |
| xTB (chimie cuantică) | optimizarea codului | de până la 2,3 ori mai rapid |
| Centrele de date Google | optimizări de memorie pe baza telemetriei din producție (anunțul din 30 septembrie) | peste 300 TiB eliberați; estimat 500 TiB–1 PiB |
Toate cifrele sunt raportate de Google, pe proiecte alese de Google. Niciuna nu are o măsurătoare independentă.
Cifra cu 35%: ce măsoară
Google spune că, în ultimele săptămâni, Argon folosit în Antigravity a ajutat echipele interne să trimită cu peste 35% mai mult cod scris de agenți și să aibă cu aproape o treime mai puține rollback-uri. Un rollback înseamnă retragerea unei modificări deja trimise, de obicei pentru că a stricat ceva. Blogul Antigravity precizează perioada (patru săptămâni) și scara: peste 100 000 de utilizatori din Alphabet folosesc lunar Argon în versiunea internă a Antigravity.
Trei lucruri lipsesc ca cifrele să poată fi comparate cu altceva:
- Baza de comparație. Nu se spune față de ce: modelul anterior, aceeași perioadă de dinainte sau echipe fără Argon.
- Ce scade la rollback-uri. Nu se precizează dacă scade numărul absolut de rollback-uri sau rata lor per modificare. Diferența contează: dacă se trimit cu 35% mai multe modificări și numărul absolut de rollback-uri scade cu 30%, rata devine 0,70 / 1,35 ≈ 0,52 din cea inițială, adică scade cu aproape jumătate.
- Calitatea. Mai mult cod trimis nu înseamnă automat mai multă productivitate. Măsoară cât cod produc agenții, nu cât valorează.
Cifrele arată o tendință în compania care a construit modelul, nu un rezultat care se transferă automat altor echipe.
Securitate și agenți
Argon a pornit ca model pentru apărare cibernetică. Prin programul Fairwind, specialiștii verificați primesc o versiune fără restricțiile de securitate cibernetică, iar din 13 octombrie programul se extinde la încă câteva sute de parteneri. Versiunea publică păstrează aceste restricții.
Pentru cine construiește agenți, anunțul are câteva cifre utile, toate raportate de Google:
- Injecție indirectă de prompt (benchmarkul Gray Swan): atacurile reușesc în 0,7% din cazuri, după 15 încercări adaptive.
- Scurtături la benchmarkurile de cod, adică încercări de a trece testele fără a rezolva sarcina: 2%.
- Pașii ireversibili: modelul este antrenat să ceară confirmarea omului înainte de acțiuni care nu se pot anula.
Ultimul punct este principiul pe care l-am întâlnit și la Dynamic Workflows din Claude Managed Agents: uneltele unui agent trebuie proiectate astfel încât o acțiune greșită sau repetată să nu producă pagube.
Ce nu spune anunțul
- Benchmarkurile sunt ale Google. Anunțurile dau scoruri doar pentru Argon, fără comparații numerice cu modelele OpenAI sau Anthropic. Un clasament independent, Artificial Analysis, îi dă 53 de puncte în Intelligence Index, locul 8 din 216 modele la 14 octombrie. Tot acolo, Argon produce mai mulți tokeni decât media modelelor comparabile, ceea ce crește costul real per sarcină.
- Prețul introductiv expiră pe 30 noiembrie. După această dată, intrarea și ieșirea costă dublu. Prețul intrării din cache după perioada introductivă nu este precizat.
- Nu există variantă gratuită în API. Modelul este disponibil doar pe nivelul plătit.
- Antigravity cere abonamentul Ultra. Abonații Pro au Argon în aplicația Gemini și în AI Mode, dar nu în Antigravity.
- Limitele de rată și detaliile tehnice (identificatorul modelului, protocolul de continuare) sunt doar în ghidul pentru dezvoltatori din AI Studio, nu în anunțuri.
Ce merită reținut
- Testează pe proiectul tău. Cifrele Google vin din proiectele Google. Rulează Argon pe aceleași sarcini pe care le dai modelului folosit acum și compară rezultatul, costul și durata.
- Calculează costul cu cache. La sesiuni lungi, diferența dintre intrarea normală și cea din cache poate reduce costul total de aproximativ 10 ori, ca în exemplul de mai sus.
- Ține cont de limita unificată. Un prompt mare lasă mai puțin loc pentru răspuns.
- Verifică migrările automat. Teste cu ieșire identică, teste de regresie și review, ca la libgav1. Un agent care rescrie cod fără o verificare independentă mută doar riscul în altă parte.
- Profită de perioada introductivă, dar planifică prețul standard. Un buget calculat la 2/10 USD se dublează din decembrie.
Pentru cine învață programare de sisteme, Argon este încă un semn că migrarea spre Rust devine o lucrare la scară industrială, făcută cu ajutorul agenților. Partea de verificare rămâne însă inginerie clasică: teste, comparații bit cu bit și review. Despre cum se formulează reguli clare pentru agenți și cum se gestionează contextul lor, vezi articolul despre reguli explicite și gestionarea contextului.