Cuprins
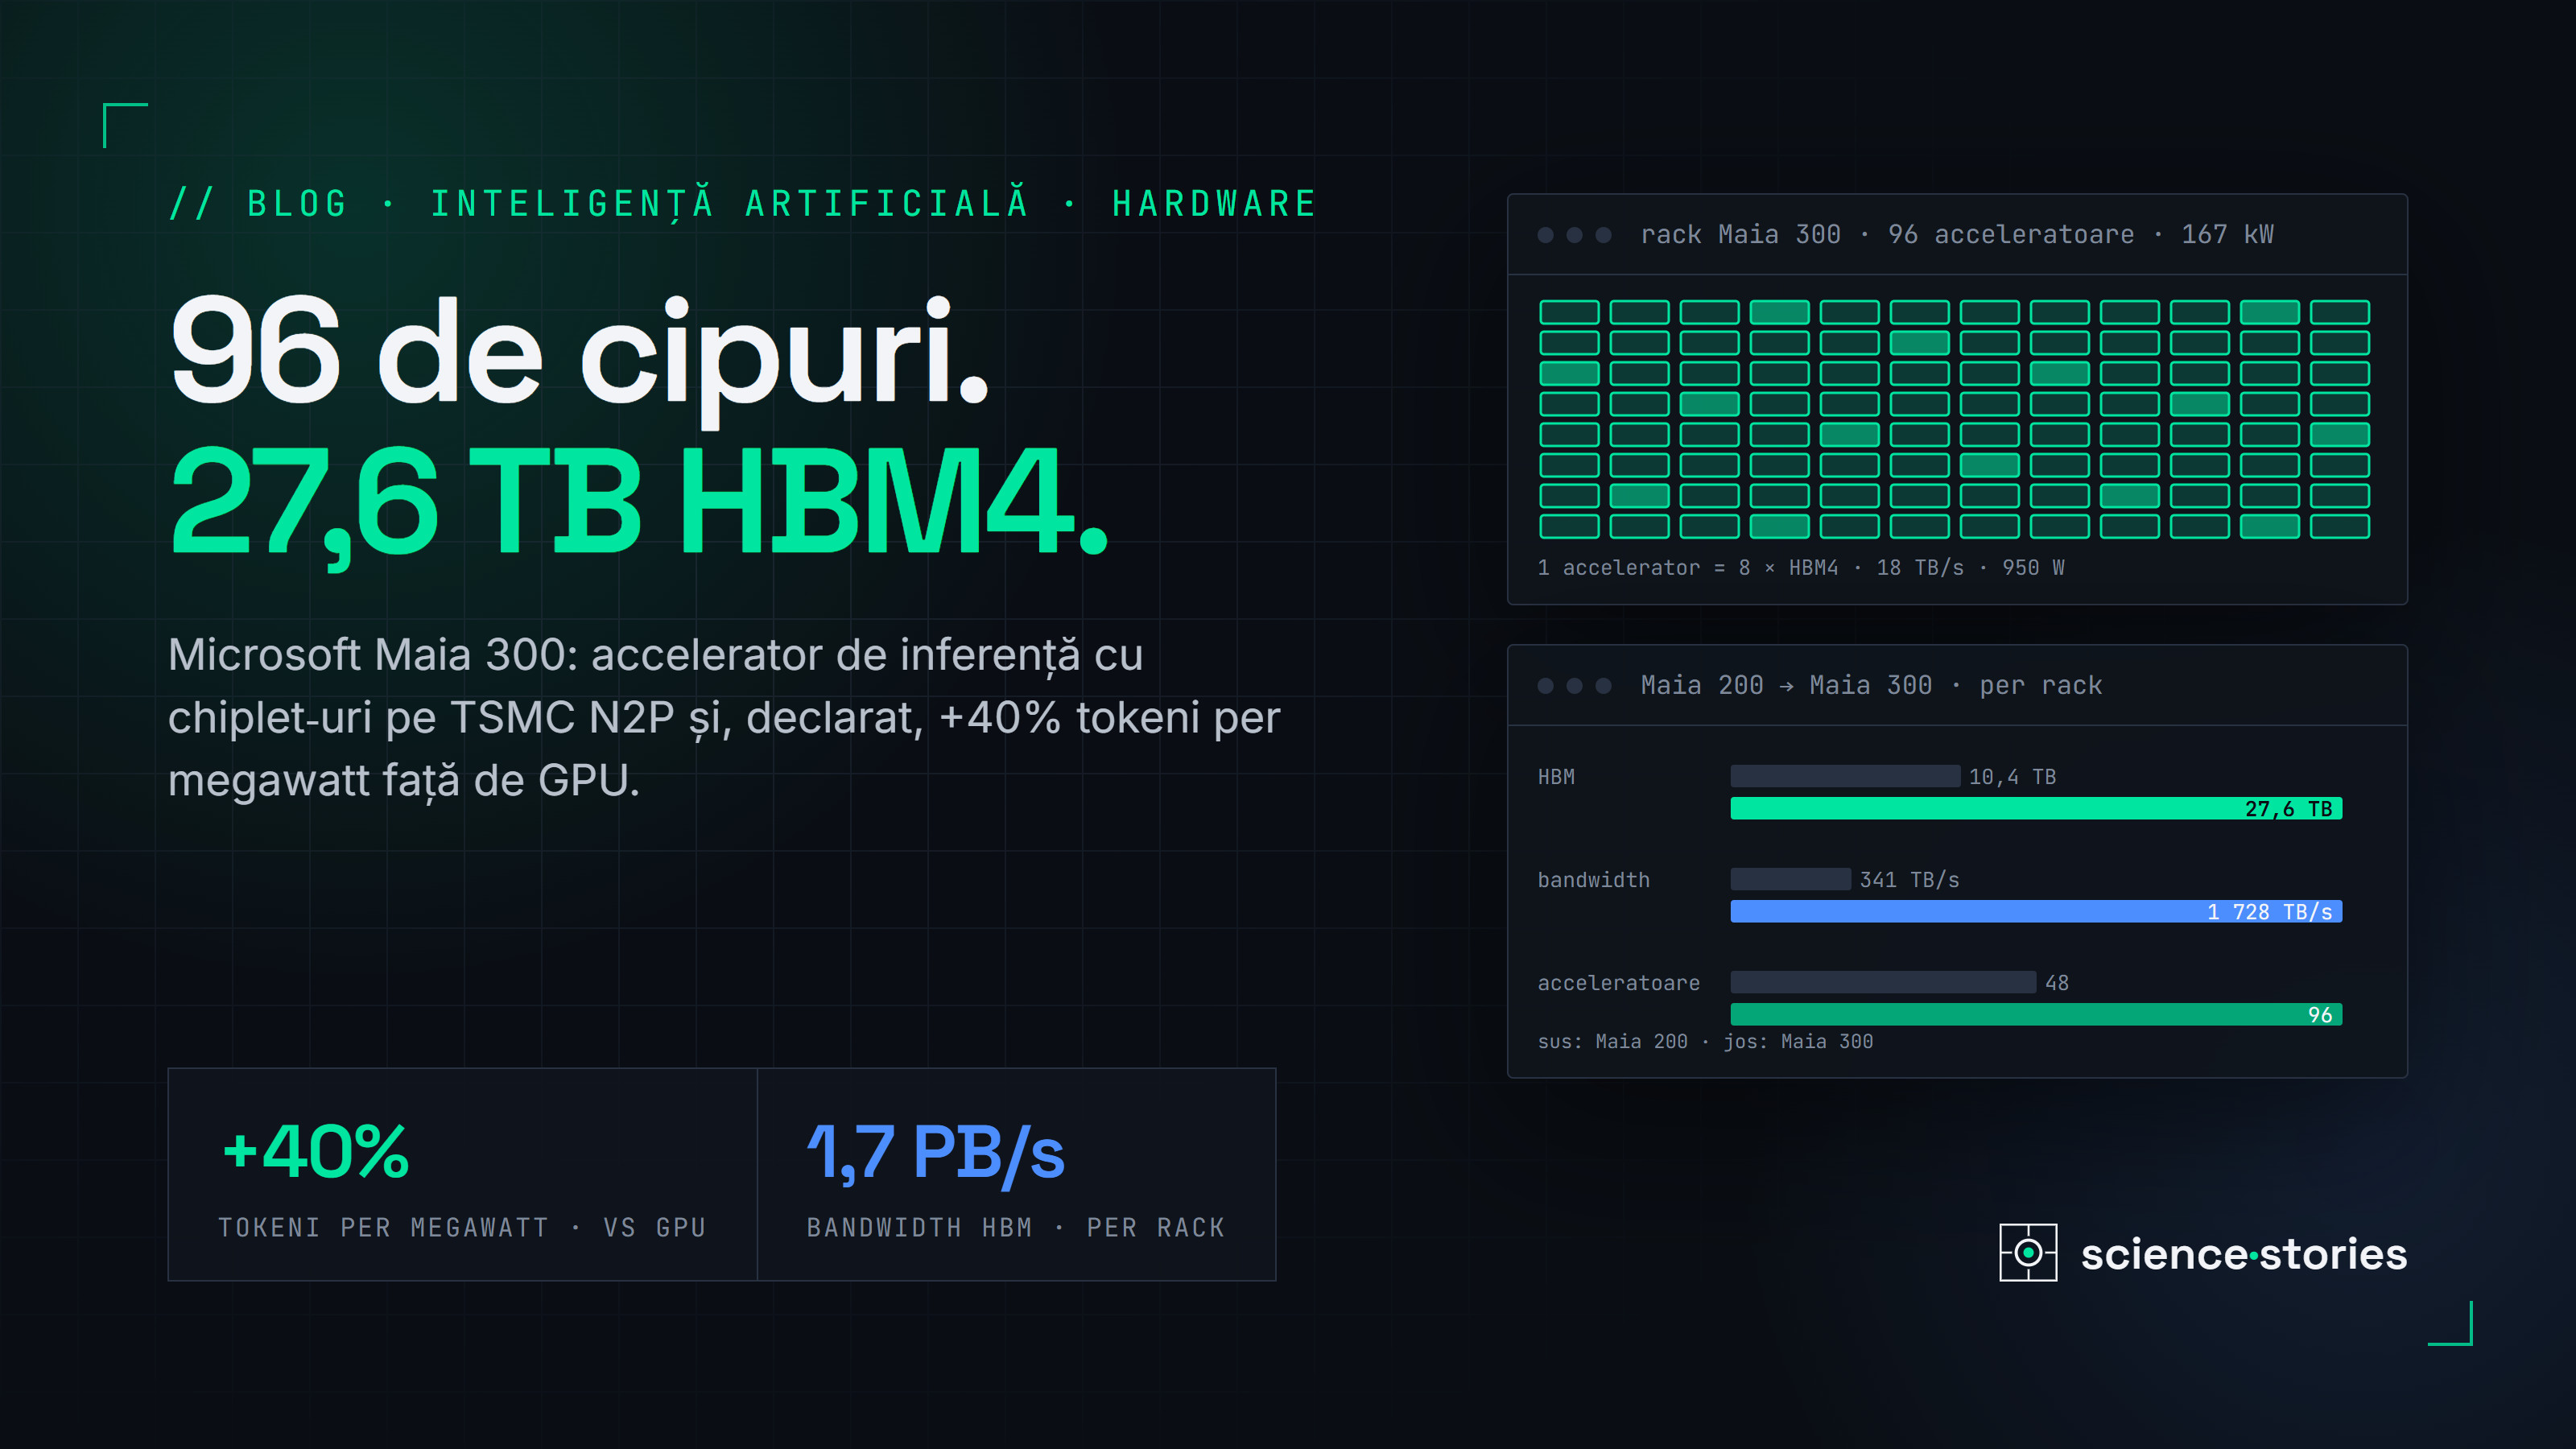
Microsoft a anunțat pe 12 octombrie 2026, într-o postare semnată de Scott Guthrie, vicepreședinte executiv pentru Cloud + AI, a treia generație a acceleratorului propriu de inteligență artificială: Azure Maia 300. Cipul este proiectat pentru inferență, adică pentru rularea modelelor de limbaj, nu pentru antrenarea lor, și va intra în producție în 2027, în implementări pe care Microsoft le descrie ca fiind de ordinul mai multor gigawați. Sursa: anunțul Microsoft.
Articolul de față verifică cifrele vehiculate în presă față de textul Microsoft, explică ce înseamnă ele pentru cine învață electronică digitală sau machine learning și notează ce lipsește din anunț.
Cifrele principale
| Parametru | Valoare |
|---|---|
| Proces de fabricație (chiplet-uri de calcul) | TSMC N2P |
| Arhitectură | multi-chiplet: calcul, controlere de memorie și I/O pe cipuri separate |
| Memorie HBM per accelerator | 8 stive HBM4 |
| Lățime de bandă a memoriei per accelerator | 18,0 TB/s (vârf) |
| Putere termică de proiectare (TDP) | 950 W |
| Formate numerice | precizie redusă, inclusiv MXFP4 „îmbunătățit” |
| Acceleratoare per rack | 96 |
| Putere per rack | 167 kW |
| Capacitate HBM per rack | 27,6 TB |
| Lățime de bandă HBM agregată per rack | 1,7 PB/s |
| Eficiență declarată | cu 40% mai mulți tokeni per megawatt decât „sistemele GPU de top” |
| Față de Maia 200 | de până la 7 ori mai mulți tokeni per rack |
| Producție | primele implementări în 2027 |
Toate valorile din tabel sunt din anunțul Microsoft. Postarea nu dă performanța de calcul (TFLOPS/POPS) și nici capacitatea HBM a unui singur accelerator.
Verificarea afirmațiilor din presă
Rezumatele care au circulat după anunț conțin câteva formulări care merită verificate:
- „Accelerator pe 2 nm”. Microsoft scrie doar TSMC N2P, fără să folosească expresia „2 nm”. N2P este varianta cu performanță îmbunătățită a familiei N2, pe care TSMC o prezintă drept procesul său de clasă 2 nm. Formularea „pe 2 nm” este deci o interpretare rezonabilă, dar nu apare în sursă. Cifra „2 nm” nu descrie oricum o dimensiune fizică a tranzistorului, ci o generație de proces.
- „Arhitectură optimizată pentru inferența LLM”. Confirmat. Microsoft vorbește de o arhitectură „inference-first”, orientată spre sarcini cu context lung, consum mare de memorie și multă generare de tokeni (faza de decodare).
- „96 de acceleratoare, 27,6 TB HBM, 1,7 PB/s per rack”. Confirmat, exact aceste cifre.
- „Cu 40% mai mulți tokeni per megawatt decât sistemele GPU de referință”. Confirmat ca afirmație, cu două rezerve. Microsoft scrie că Maia 300 „este de așteptat” să atingă această valoare, deci este o proiecție, nu o măsurătoare publicată. Iar sistemul GPU cu care se compară nu este numit: nici producătorul, nici modelul, nici modelul de limbaj rulat.
- „Primele implementări în producție în 2027”. Confirmat.
Pe scurt: cifrele sunt corecte, iar singura formulare care depășește sursa este „2 nm”.
Ce înseamnă „tokeni per megawatt”
Pentru un centru de date, limita reală este puterea electrică disponibilă, nu numărul de cipuri. De aceea Microsoft nu compară cipurile între ele, ci câți tokeni pe secundă poate produce un sistem la o putere dată. Dacă R este rata de tokeni și P puterea consumată, energia pe token este:
„Cu 40% mai mulți tokeni per megawatt” înseamnă că, la aceeași putere, R crește de 1,4 ori. Echivalent, energia pe token scade la 1 / 1{,}4 \approx 0{,}71, adică o reducere de aproximativ 29% a energiei per token. Pentru o implementare de un gigawatt, diferența dintre cele două formulări este de ordinul sutelor de megawați, de aceea metrica este importantă pentru operator.
Metrica are și o limită: depinde de modelul rulat, de lungimea contextului, de numărul de utilizatori serviți simultan și de software. Fără aceste detalii, valoarea nu poate fi reprodusă de altcineva.
De ce contează memoria mai mult decât calculul
Generarea unui răspuns de către un model de limbaj are două faze. În faza de prefill, modelul procesează promptul; aici domină calculul. În faza de decodare, modelul produce tokenii unul câte unul. Pentru fiecare token nou trebuie citite din memorie toate ponderile modelului și KV cache-ul (cheile și valorile calculate pentru tokenii anteriori). Calculul pe token este mic, dar volumul de date citit este uriaș. De aceea decodarea este limitată de lățimea de bandă a memoriei, nu de numărul de operații pe secundă.
Un calcul simplu arată de ce HBM-ul este în centrul anunțului. Dacă un accelerator citește B octeți la fiecare token, cu o lățime de bandă W, timpul minim per token este:
Cu W = 18 TB/s, citirea a 288 GB (cât revine unui accelerator din cei 27,6 TB ai rack-ului) durează cel puțin 16 ms, adică cel mult aproximativ 62 de tokeni pe secundă pentru un singur flux de generare. În practică se servesc multe cereri în paralel, iar ponderile se citesc o dată pentru tot lotul, de aceea debitul total este mult mai mare. Dar relația de mai sus explică de ce producătorii de acceleratoare de inferență se întrec în lățime de bandă, nu în TFLOPS.
Aici intră și MXFP4. Este un format în virgulă mobilă pe 4 biți cu exponent partajat pe bloc de valori, definit în specificația „Microscaling” a Open Compute Project. Stocarea ponderilor și a KV cache-ului pe 4 biți reduce de patru ori octeții citiți per token față de 16 biți, deci reduce direct B din formula de mai sus. Microsoft spune că Maia 300 are suport „îmbunătățit” pentru MXFP4, fără să detalieze.
Chiplet-uri și HBM4
Maia 300 este primul cip Maia construit din mai multe cipuri (chiplet-uri) montate în același pachet. Microsoft spune că funcțiile de calcul, controler de memorie și I/O stau pe cipuri separate, iar doar cele de calcul sunt fabricate pe N2P. Avantajul este economic și tehnic în același timp: procesul cel mai scump și cel mai nou este folosit doar acolo unde contează, adică pentru logică, iar interfețele analogice și controlerele de memorie, care nu se micșorează la fel de bine, rămân pe procese mature.
Potrivit analizei StorageReview, pachetul conține un cip de calcul, două cipuri de I/O și patru cipuri de memorie, iar fiecare accelerator are 288 GB HBM4. Valoarea este consecventă cu anunțul Microsoft: 96 × 288 GB = 27,6 TB per rack, iar 96 × 18 TB/s ≈ 1,7 PB/s.
HBM (High Bandwidth Memory) este memorie DRAM stivuită vertical și conectată la procesor printr-un număr foarte mare de linii paralele, pe un substrat de siliciu. Generația HBM4 dublează lățimea interfeței fiecărei stive față de HBM3E, de la 1024 la 2048 de linii de date, ceea ce explică saltul de lățime de bandă fără o creștere proporțională a frecvenței.
Comparație cu Maia 200
Maia 200, generația anterioară, este deja în producție în Statele Unite, Europa și Australia și rulează, potrivit Microsoft, Microsoft Copilot și modelele echipei MAI; GitHub Copilot și Microsoft Foundry urmează să treacă pe ea până la sfârșitul anului. Pentru funcțiile AI integrate din Teams, Copilot și Cowork, Microsoft susține că Maia 200 oferă de până la 1,7 ori mai mulți tokeni per watt decât infrastructura GPU de top.
Cifrele de mai jos pentru Maia 200 și cele marcate cu asterisc pentru Maia 300 provin din analiza StorageReview, nu din postarea Microsoft:
| Parametru | Maia 200 | Maia 300 |
|---|---|---|
| Proces | TSMC N3P, cip monolitic | TSMC N2P, chiplet-uri |
| HBM per accelerator | 6 × HBM3E, 216 GB | 8 × HBM4, 288 GB* |
| Lățime de bandă per accelerator | 7,1 TB/s | 18,0 TB/s |
| TDP | 750 W | 950 W |
| Acceleratoare per rack | 48 | 96 |
| Putere per rack | 64 kW | 167 kW |
| HBM per rack | 10,4 TB | 27,6 TB |
| Calcul de vârf FP4 | 10,1 POPS | 13,8 POPS* |
Două observații:
- Calculul crește cu doar 37% (13,8 față de 10,1 POPS), dar lățimea de bandă per accelerator crește de 2,5 ori. Este exact prioritatea descrisă în secțiunea anterioară.
- Puterea per rack crește de 2,6 ori, iar numărul de acceleratoare se dublează. Cei 96 × 950 W = 91 kW ai acceleratoarelor sunt doar o parte din cei 167 kW ai rack-ului; restul revine rețelei de interconectare, procesoarelor gazdă, răcirii și conversiei de putere. Monitorizarea unor astfel de linii de alimentare este, de altfel, subiectul unui anunț Texas Instruments făcut în aceeași zi.
Cei „de până la 7 ori mai mulți tokeni per rack” declarați de Microsoft rezultă din combinația dintre dublarea numărului de cipuri, creșterea lățimii de bandă și formatele pe 4 biți. Ca și cifra de 40%, este o valoare maximă declarată de producător.
Interconectare
Microsoft descrie legături de mare viteză între acceleratoare, optimizate pentru paralelism tensorial (un model împărțit pe mai multe cipuri care lucrează la același token), și un protocol de transport propriu care rulează peste Ethernet. Alegerea Ethernet-ului în locul unei interconectări proprietare este semnificativă: permite aceeași topologie de la un rack până la întregul centru de date, cu echipamente de rețea standard. Potrivit StorageReview, fiecare accelerator are 32 de porturi Ethernet de 400 Gb/s, iar domeniul de scalare ajunge la aproximativ 12 000 de acceleratoare.
Ce nu spune anunțul
- Sistemul GPU de referință nu este numit. Cifra de 40% nu poate fi verificată independent fără modelul GPU, modelul de limbaj și configurația de servire.
- „Este de așteptat”. Maia 300 nu este încă în producție, deci eficiența declarată este o proiecție bazată pe simulări sau pe mostre, nu o măsurătoare pe sisteme instalate.
- Nu există cifre de calcul în postarea Microsoft. Valorile POPS de mai sus vin dintr-o sursă secundară.
- Nu este un produs pentru terți. Maia este folosit intern de Azure și de serviciile Microsoft. Nu există preț și nici disponibilitate pentru clienți externi.
- Detalii abia în noiembrie. Microsoft promite mai multe informații la Ignite 2026.
Pentru cine studiază arhitectura calculatoarelor, Maia 300 este un exemplu bun de proiectare pornind de la constrângerea reală: la inferență, limita este mișcarea datelor și energia pe token, nu numărul de operații. Fundamentele care stau în spatele acestor alegeri, de la organizarea memoriei până la formatele numerice, sunt discutate în cursurile Electronica digitală și Machine Learning.