Cuprins
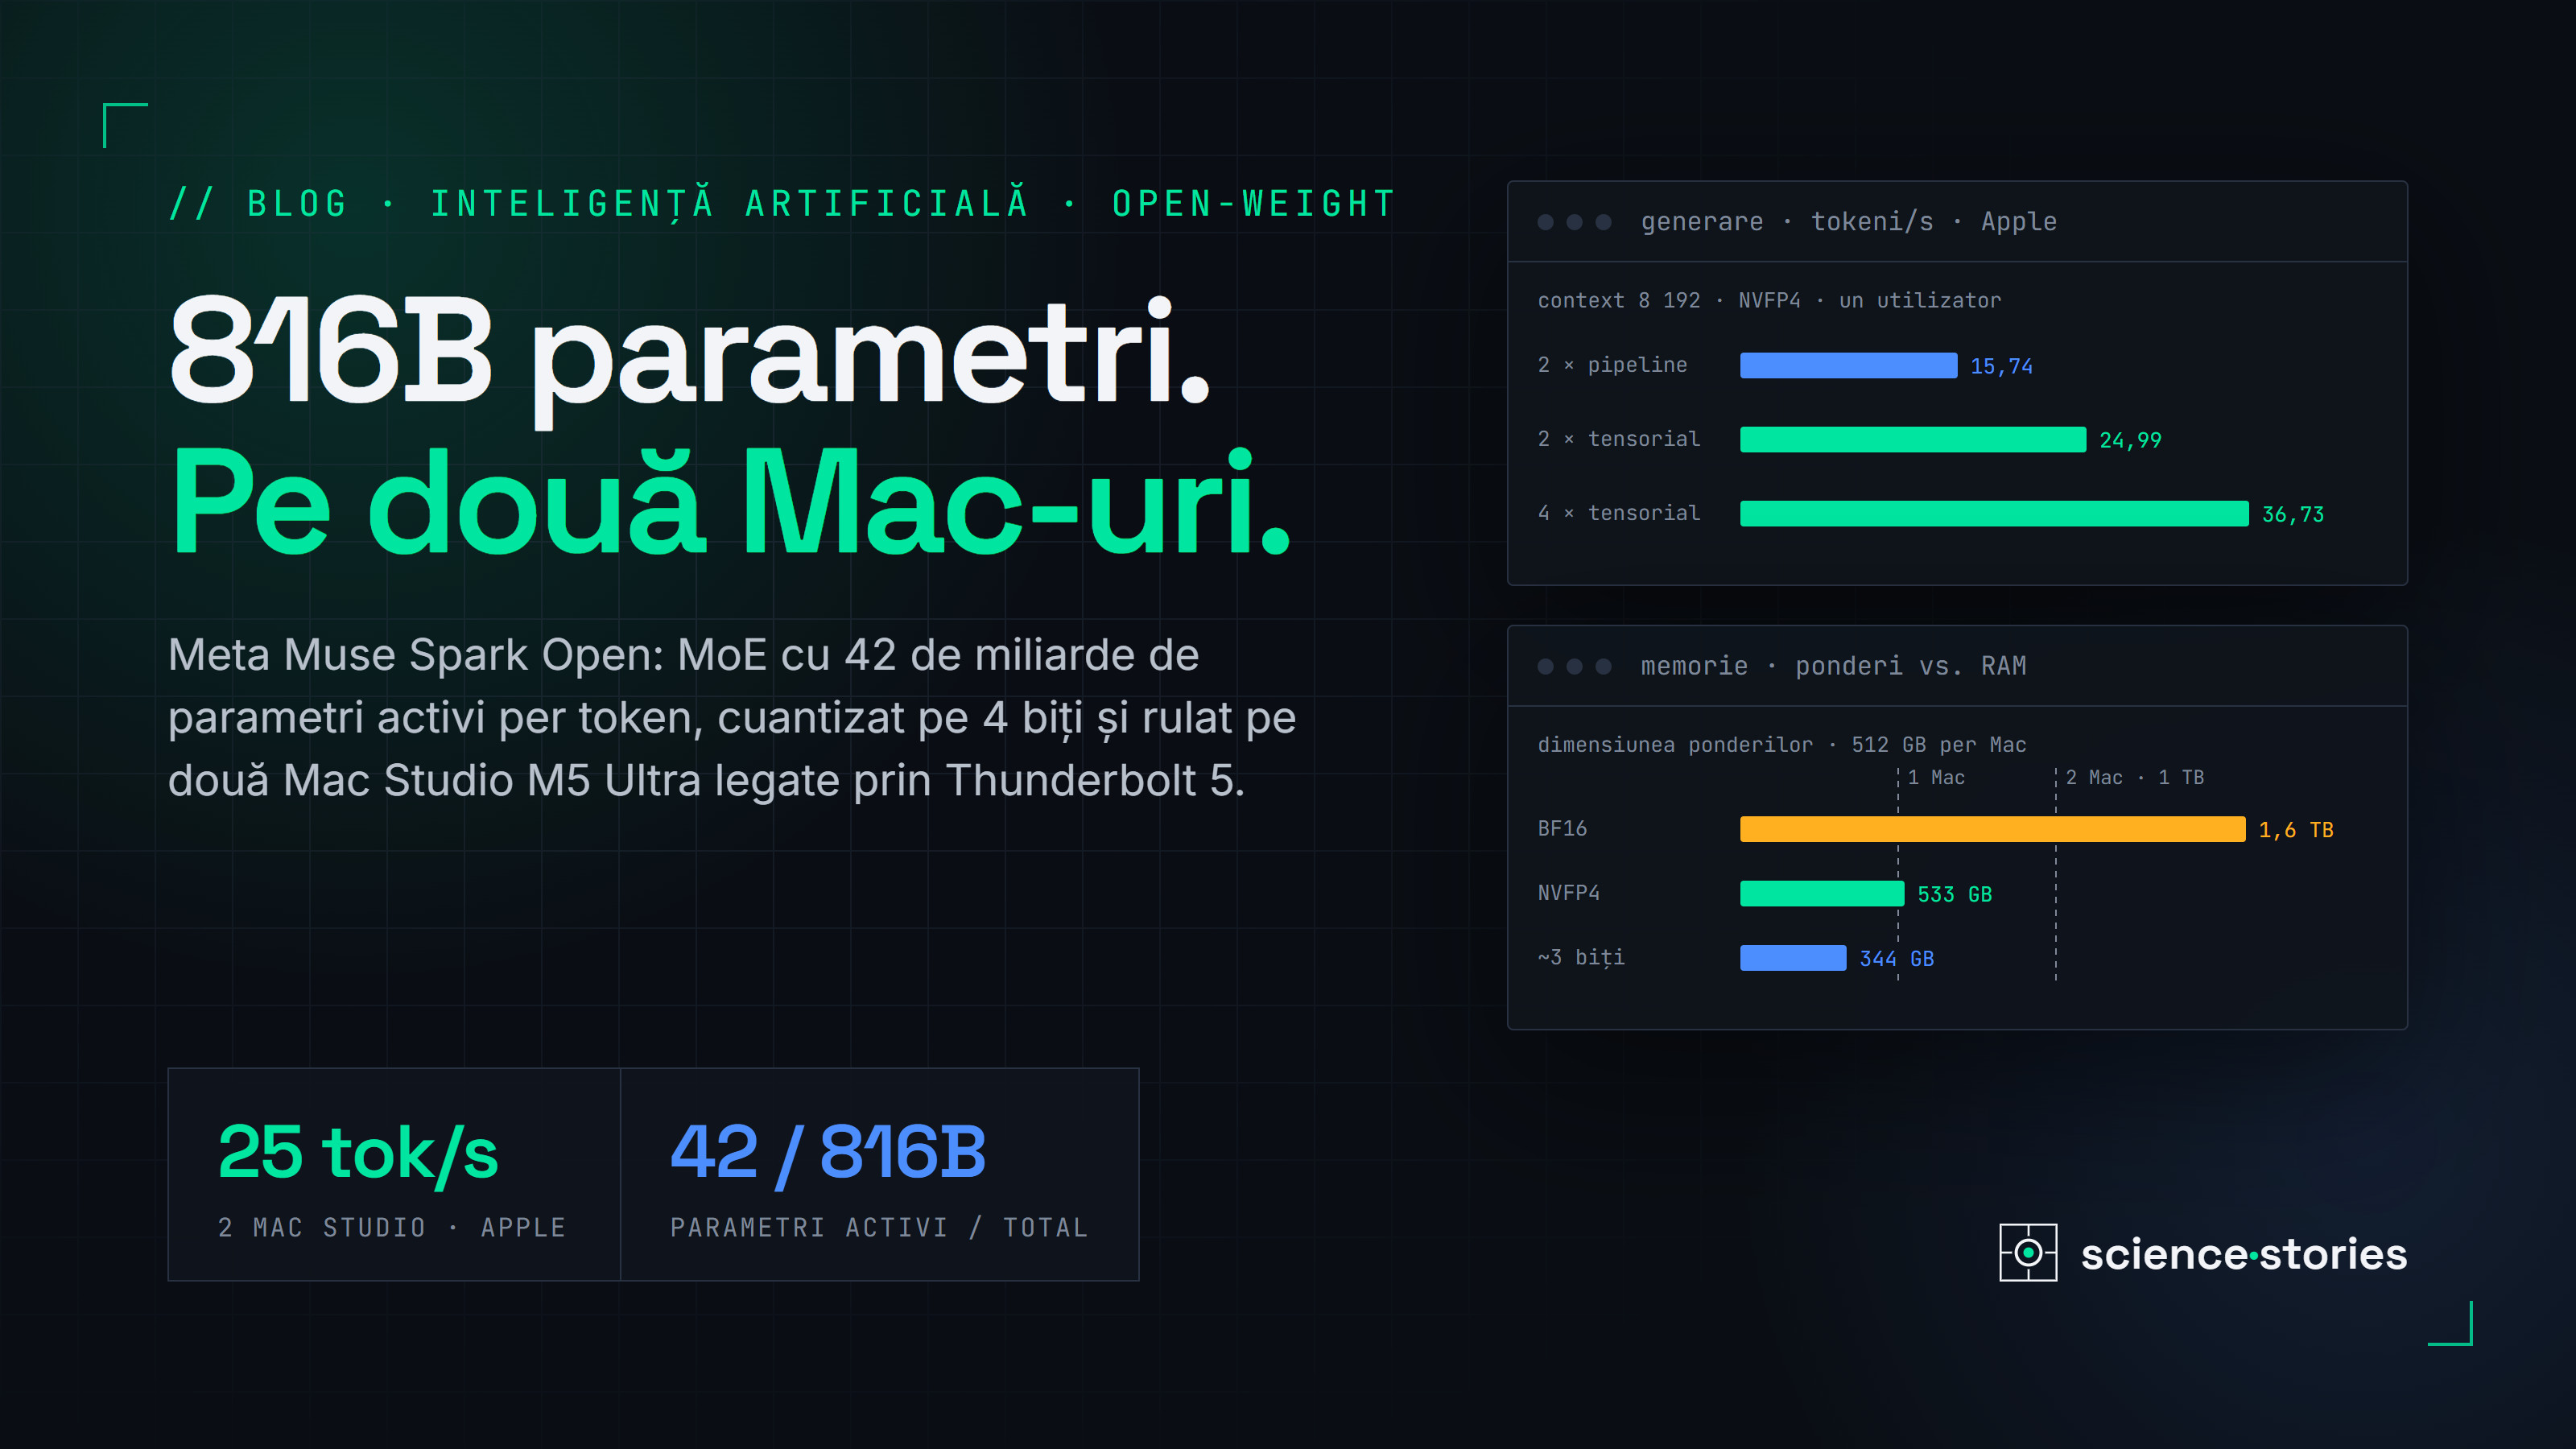
Pe 15 octombrie 2026, Meta a publicat ponderile modelului Muse Spark Open, versiunea open-weight a modelului Muse Spark. Este un model de tip mixture of experts (MoE) cu 816 miliarde de parametri, din care aproximativ 42 de miliarde lucrează la fiecare token, și cu o fereastră de context de 1 milion de tokeni. Primește text, imagini, video și audio și răspunde în text. Meta spune că l-a construit pentru programare și agenți și îl numește „cel mai capabil model open-weight american de până acum”. Sursa: anunțul Meta AI Research.
Partea care a atras atenția este hardware-ul. Modelul rulează pe două Mac Studio cu M5 Ultra și câte 512 GB de memorie, legate prin Thunderbolt 5, cu framework-ul MLX al Apple. În aceeași zi, Apple a publicat măsurătorile proprii, iar Meta un ghid tehnic pentru dezvoltatori. Articolul verifică rezumatul care circulă despre lansare, explică de ce un model de 816 miliarde de parametri încape pe două calculatoare de birou și ce viteză poți aștepta de la el, apoi rezumă ce permite licența.
Cifrele principale
| Parametru | Valoare |
|---|---|
| Lansare | 15 octombrie 2026 |
| Arhitectură | MoE cu 62 de straturi; 256 de experți per bloc MoE, din care 8 aleși pentru fiecare token |
| Parametri | ~816 miliarde în total, ~42 de miliarde activi per token |
| Intrări / ieșire | text, imagini, video și audio / text |
| Context | până la 1 048 576 de tokeni |
| Ponderi publicate de Meta | BF16 (~1,6 TB) și NVFP4 (~530 GB, doar experții pe 4 biți) |
| Pe GPU-uri | NVFP4 pe patru GPU-uri NVIDIA Blackwell Ultra sau opt H200 |
| Pe Mac | 2 × Mac Studio M5 Ultra cu 512 GB sau 4 × cu 256 GB, MLX, Thunderbolt 5 cu RDMA |
| Viteză de generare pe Mac (Apple) | 15,7 tokeni/s (2 Mac, pipeline), 25,0 (2 Mac, tensorial), 36,7 (4 Mac, tensorial) |
| Raționament | patru niveluri, de la low la xhigh (implicit); nu poate fi oprit |
| Disponibilitate | Hugging Face (acces aprobat manual), SageMaker AI, Google Cloud, Microsoft Foundry, 7 furnizori de API |
| Licență | Muse Model License: gratuită, cu atribuire obligatorie și restricții (detalii mai jos) |
Valorile sunt din anunțul Meta, din ghidul pentru dezvoltatori, din blogul tehnic Hugging Face, din metadatele depozitului de pe Hugging Face și din postarea Apple. Vitezele pe Mac sunt pentru un context de 8 192 de tokeni și un singur utilizator.
Verificarea afirmațiilor
Rezumatul care circulă spune: Meta lansează Muse Spark Open, model multimodal MoE cu 816 miliarde de parametri, 42B activi și context de 1 milion de tokeni, open-weight, optimizat pentru Apple Silicon și specializat în coding și agenți AI. Poate rula local pe două Mac Studio M5 Ultra cu câte 512 GB RAM, prin MLX, ponderile sunt pe Hugging Face, iar licența permite utilizarea comercială cu anumite restricții.
- „Publicat pe 15 octombrie”. Confirmat.
- „Model multimodal MoE cu 816 miliarde de parametri, 42B activi și context de 1 milion de tokeni”. Confirmat. „Multimodal” se referă la intrări: text, imagini, video și audio. Ieșirea este doar text. Fișierele de pe Hugging Face conțin 822 de miliarde de valori. Diferența de 6 miliarde are ordinul de mărime al encoderului de imagine (1,8 miliarde) și al matricelor de intrare și ieșire (câte 1,66 miliarde), dar Meta nu o explică.
- „Optimizat pentru Apple Silicon”. Parțial corect. Meta a lucrat cu Apple ca MLX să ruleze modelul din prima zi și numește perechea de Mac Studio „cea mai bună modalitate” de a-l rula pe birou. Formatul folosit pe Mac, NVFP4, este însă creat de NVIDIA pentru GPU-urile Blackwell. Modelul rulează la lansare și pe GPU-uri NVIDIA, AMD și Intel, cu SGLang, vLLM sau TensorRT-LLM. Mac-ul este una dintre platformele optimizate, nu singura.
- „Specializat în coding și agenți AI”. Parțial corect. Așa îl descrie Meta: „construit pentru programare și muncă agentică”. Tabelul publicat chiar de Meta arată că modelul conduce la benchmarkurile agentice, dar este în urma modelelor Kimi K3 și GLM 5.3 la ambele benchmarkuri de programare, Terminal-Bench 2.1 și DeepSWE 1.1. Detalii mai jos.
- „Poate rula local pe două Mac Studio M5 Ultra cu câte 512 GB, prin MLX”. Confirmat, cu trei precizări. Pe Mac rulează varianta cuantizată pe 4 biți (NVFP4), nu ponderile complete de 1,6 TB. Merge și pe patru Mac Studio cu câte 256 GB. Și ai nevoie de macOS 26.2 sau mai nou, MLX 0.30.1 sau mai nou și legături Thunderbolt 5 directe între mașini. Cu cuantizări mai agresive, de 2–3 biți, modelul încape și pe un singur Mac de 512 GB, după testele Hugging Face.
- „Ponderile sunt disponibile pe Hugging Face”. Confirmat, dar nu liber. Descărcarea cere un formular (nume complet, data nașterii, țara, organizația) și o aprobare manuală. Ponderile sunt și în catalogele Amazon SageMaker AI, Google Cloud Model Garden și Microsoft Foundry Models.
- „Licența permite utilizarea comercială cu anumite restricții”. Confirmat. Restricțiile concrete sunt atribuirea „Built with Muse Spark Open”, un acord separat pentru firmele mari care vând acces la modele prin API și o politică de utilizare cu interdicții. Detalii în secțiunea despre licență.
Rezumatul este corect în linii mari. De corectat sunt „specializat în coding”, pe care benchmarkurile Meta nu îl susțin față de modelele chinezești, și faptul că pe Mac rulează o versiune pe 4 biți, nu modelul complet.
Ce înseamnă 816 miliarde, dar 42 active
Un model de limbaj dens folosește toți parametrii pentru fiecare token. Un model mixture of experts înlocuiește rețeaua feed-forward din straturi cu mai multe rețele mai mici, numite experți, plus un router. Routerul alege, pentru fiecare token, câțiva experți, iar ceilalți nu calculează nimic.
Muse Spark Open are 62 de straturi. Blocurile MoE au câte 256 de experți, iar routerul alege 8 pentru fiecare token. Așa ajunge modelul să calculeze fiecare token cu aproximativ 42 de miliarde de parametri, deși are 816 miliarde în total. Experții conțin aproape tot modelul: în metadatele depozitului NVFP4, 773 din cei 822 de miliarde de parametri, adică 94%, aparțin experților.
Arhitectura are două consecințe practice:
- Calculul și traficul de memorie per token sunt cele ale unui model de 42 de miliarde de parametri. De aici vine viteza.
- Memoria ocupată este cea a unui model de 816 miliarde. La următorul token, routerul poate alege oricare dintre experți, așa că toți trebuie să stea în memorie.
Un MoE mare are deci nevoie de multă capacitate de memorie și de o lățime de bandă moderată. Asta se potrivește cu un Mac Studio, care are 512 GB de memorie unificată și 1,2 TB/s, mai bine decât cu un GPU, care are o lățime de bandă mult mai mare, dar o memorie de numai câteva sute de GB. Interpretarea este a noastră.
De ce încape pe două Mac Studio
În BF16, cu 16 biți per parametru, ponderile ocupă aproximativ 1,6 TB. Două Mac Studio cu câte 512 GB au împreună 1 TB, deci nu ajung.
Varianta NVFP4 publicată de Meta stochează parametrii experților pe 4 biți, în virgulă mobilă, cu câte un factor de scală pe 8 biți pentru fiecare bloc de 16 valori. Costul real per parametru este deci:
Restul modelului, adică atenția, matricele de intrare și ieșire și encoderele, rămâne în BF16. Din metadate rezultă bilanțul: 773 de miliarde de parametri pe 4,5 biți înseamnă circa 435 GB, iar 49 de miliarde de parametri în BF16 încă 98 GB. Totalul, de aproximativ 533 GB, este chiar dimensiunea fișierelor de pe Hugging Face. Apple dă aproximativ 493 GB ocupați în memorie. Cu memoria pentru calculele intermediare și pentru KV cache, modelul nu încape pe un singur Mac de 512 GB, dar încape pe două.
Modelul se poate împărți între mașini în două feluri:
- Paralelism pe pipeline. Primul Mac rulează prima jumătate a straturilor, al doilea pe a doua. Între mașini circulă doar rezultatul de la jumătatea modelului, dar la generare mașinile lucrează pe rând, așa că viteza este cea a unei singure mașini.
- Paralelism tensorial. Fiecare strat este împărțit între mașini. Fiecare Mac are câte o parte din fiecare matrice și face simultan partea lui de calcul. Este mai rapid, dar cere schimburi de date la fiecare strat, pentru fiecare token, deci o legătură cu latență foarte mică.
Legătura folosește RDMA peste Thunderbolt 5, adăugat în macOS 26.2: un Mac scrie direct în memoria celuilalt, fără să treacă prin stiva de rețea a sistemului de operare. MLX folosește acest driver prin backendul jaccl. Apple leagă fiecare pereche de mașini cu două cabluri, ca să dubleze banda. La patru Mac-uri și un context de 65 536 de tokeni, al doilea cablu scade timpul până la primul token de la 50,5 la 40,6 s. Un Mac Studio cu M5 Ultra are șase porturi Thunderbolt 5, exact câte cere o rețea completă de patru mașini, cu câte două cabluri pe fiecare legătură.
Pornirea serverului, din ghidul Meta pentru Mac, este o singură comandă rulată pe primul Mac:
mlx.launch --hostfile hostfile.json --backend jaccl --env MLX_METAL_FAST_SYNCH=1 -- \
  mlx_lm.server --model meta-models/Muse-Spark-Open-816B-A42B-NVFP4 --port 8080
mlx.launch pornește același program prin SSH pe toate Mac-urile din hostfile.json, iar serverul oferă pe portul 8080 un API compatibil OpenAI, pe care îl pot folosi uneltele de programare cu agenți. Fiecare Mac încarcă modelul de pe propriul disc, deci are nevoie de circa 530 GB liberi pentru tot checkpointul NVFP4.
Cât de repede generează: un calcul de verificare
Apple a măsurat modelul în NVFP4, cu un singur utilizator și 128 de tokeni generați după context. Fiecare celulă dă două valori: la 8 192 și la 65 536 de tokeni de context.
| Configurație | Primul token | Generare, tokeni/s |
|---|---|---|
| 2 Mac Studio, pipeline | 8,4 s / 47,6 s | 15,74 / 14,37 |
| 2 Mac Studio, tensorial | 8,2 s / 70,3 s | 24,99 / 23,84 |
| 4 Mac Studio, tensorial | 4,8 s / 40,6 s | 36,73 / 34,66 |
La generare, fiecare token nou cere citirea din memorie a tuturor parametrilor activi. Pentru un singur utilizator, viteza este limitată de lățimea de bandă a memoriei, nu de puterea de calcul, cum am arătat la acceleratorul Microsoft Maia 300. Timpul minim per token este raportul dintre octeții citiți B și lățimea de bandă W:
Cu N_{activ} = 42 \cdot 10^9 și b = 4{,}5 biți, rezultă B \approx 23{,}6 GB. Cu W = 1{,}2 TB/s, t_{min} \approx 19{,}7 ms, adică cel mult ~51 de tokeni/s când mașinile lucrează pe rând, în pipeline. În paralelism tensorial, fiecare Mac citește doar jumătate din parametri, deci limita se dublează la ~102 tokeni/s. Pe patru Mac-uri ajunge la ~203 tokeni/s.
Măsurătorile Apple reprezintă 31%, 25% și 18% din aceste limite. Diferența are mai multe cauze. Nu toți parametrii activi sunt pe 4 biți: atenția rămâne în BF16, care cântărește de 3,6 ori mai mult per parametru. Se citește și KV cache-ul. Paralelismul tensorial adaugă schimburi de date la fiecare strat, iar scăderea procentului de la două la patru mașini arată costul acestei comunicații. Estimarea este a noastră și dă doar o limită superioară.
Același calcul arată de ce arhitectura MoE face posibilă rularea locală. Un model dens de 816 miliarde de parametri, tot pe 4,5 biți, ar cere citirea a 459 GB pentru fiecare token, adică cel mult 2,6 tokeni/s la aceeași lățime de bandă.
Cât înseamnă 25 de tokeni/s în practică? Modelul raționează înainte să răspundă, iar raționamentul nu poate fi oprit, doar redus la nivelul low. Un exemplu ipotetic: dacă un pas al unui agent produce 3 000 de tokeni de raționament și 1 000 de tokeni de cod, pe două Mac-uri în paralelism tensorial pasul durează 4 000 / 25 = 160 s, aproape trei minute.
Există și varianta cu un singur Mac. Hugging Face a testat cuantizări mai agresive pe un Mac Studio M3 Ultra cu 512 GB, generația anterioară: o cuantizare de 2 biți ocupă 304 GB și generează 18 tokeni/s, iar una de aproximativ 3 biți ocupă 344 GB și generează 21 de tokeni/s. Testele au folosit un prompt de doar 1 024 de tokeni, deci nu se compară direct cu cele Apple. Cât pierde modelul din calitate la 2–3 biți nu este publicat.
1 milion de tokeni, pe birou
KV cache-ul păstrează cheile și valorile calculate de mecanismul de atenție pentru tokenii din context. Hugging Face calculează pentru Muse Spark Open circa 250 KB per token în BF16, adică 266 GB pentru un context complet de 1 milion de tokeni. Pe două Mac Studio, după cei aproximativ 493 GB ai modelului, rămân circa 530 GB, din care o parte îi trebuie sistemului de operare. Pe hârtie, contextul complet încape.
Problema este prefill-ul, faza în care modelul procesează tot promptul înainte de primul token generat. La 65 536 de tokeni, cele trei configurații Apple procesează în medie 1 377, 932 și 1 614 tokeni/s. La aceleași ritmuri, un prompt de 1 048 576 de tokeni ar cere:
| Configurație | Ritm de prefill la 65 536 tokeni | Timp estimat pentru 1M tokeni |
|---|---|---|
| 2 Mac Studio, pipeline | 1 377 tokeni/s | ~12,7 minute |
| 2 Mac Studio, tensorial | 932 tokeni/s | ~18,8 minute |
| 4 Mac Studio, tensorial | 1 614 tokeni/s | ~10,8 minute |
Calculul este al nostru, iar timpii reali ar fi mai mari: costul atenției crește cu lungimea contextului, deci ritmul de prefill scade. Apple nu a măsurat peste 65 536 de tokeni. Tot din tabelul Apple reiese că, la 65 536 de tokeni, paralelismul tensorial pe două mașini este mai lent la prefill decât pipeline-ul. Apple explică diferența prin arhitectură: normalizarea separată a ieșirilor experților adaugă comunicație între mașini, iar costul ei se recuperează abia la patru Mac-uri.
Generarea propriu-zisă aproape nu încetinește: de la 8 192 la 65 536 de tokeni de context, viteza scade cu doar 5–9%. Pentru un agent, contează deci cum crește contextul. Dacă serverul păstrează KV cache-ul între ture, se procesează doar tokenii noi. Costul complet apare când încarci dintr-odată un proiect mare sau când cache-ul se pierde. Este aceeași problemă pe care o rezolvă, la scara unui centru de date, expandoarele de memorie CXL de la Marvell: un KV cache pierdut înseamnă un prefill reluat.
Benchmarkurile, citite atent
Meta compară Muse Spark Open cu șapte modele open-weight. Tabelul de mai jos arată, pentru fiecare benchmark, scorul Muse Spark Open și cel mai bun scor al celorlalte modele:
| Domeniu | Benchmark | Muse Spark Open | Cel mai bun alt model |
|---|---|---|---|
| Agenți | JobBench | 61,8 | 61,4 (GLM 5.3) |
| Agenți | MCP-Atlas | 89,2 | 84,5 (Qwen3.8) |
| Agenți | GDPval-AA v2 | 1401 | 1653 (GLM 5.3) |
| Raționament | HLE-Diamond, fără unelte | 26,1 | 22,2 (Kimi K3) |
| Raționament | SciCode | 58,5 | 59,5 (Kimi K3) |
| Raționament | AA-Omniscience | 25 | 20 (Kimi K3) |
| Programare | Terminal-Bench 2.1 | 76,4 | 85,0 (Kimi K3) |
| Programare | DeepSWE 1.1 | 60 | 68 (Kimi K3) |
| Multimodal | ZeroBench, cu unelte | 50,0 | 41,0 (Kimi K3) |
| Multimodal | BabyVision, cu unelte | 80,2 | 85,7 (Kimi K3) |
| Multimodal | SimpleVQA, cu unelte | 73,6 | 71,9 (Kimi K3) |
Muse Spark Open câștigă 6 din 11 rânduri. Conduce la sarcinile agentice cu unelte (MCP-Atlas măsoară folosirea unor servere MCP reale) și la cunoștințe, unde AA-Omniscience penalizează răspunsurile inventate. La programare, însă, ambele benchmarkuri îl arată în urma modelelor Kimi K3 și GLM 5.3. La Terminal-Bench 2.1 este depășit și de Qwen3.8 și Beam, iar la DeepSWE și de Mistral Large 4. Calificativul „american” din titlul Meta contează: cele mai bune modele de cod din tabel sunt chinezești. Qwen3.8 are, după nume, 2,4 mii de miliarde de parametri, de aproape trei ori mai mulți.
Raportul de metodologie adaugă câteva precizări:
- Rezultatele vin din surse diferite. Unele sunt din clasamente oficiale, altele din rulările Meta, iar pentru Beam și Mistral Large 4 sunt cele raportate de producători.
- La DeepSWE, fiecare model a rulat cu propriul mediu de agent. Muse Spark Open cu Muse Code, Kimi K3 cu Kimi Code, Qwen3.8 cu Claude Code, GLM 5.3 cu mini-swe-agent. Scorul măsoară perechea model–unealtă, nu doar modelul.
- Meta recunoaște că setările ei nu sunt optimizate pentru modelele altora. Pentru fiecare model a folosit nivelul maxim de raționament disponibil.
- Nu se spune în ce precizie a fost evaluat Muse Spark Open. Nu știm deci cât din aceste scoruri se păstrează în NVFP4, pe Mac. Hugging Face spune doar că pierderea de acuratețe a formatului NVFP4 este „neglijabilă”.
Licența, pe scurt
Ponderile sunt publicate sub Muse Model License. Este o licență open-weight, nu open source: ponderile sunt disponibile, dar licența impune condiții și interdicții de utilizare, iar datele de antrenare nu sunt publicate. Principalele prevederi:
- Utilizarea este gratuită. Poți folosi, modifica, ajusta (fine-tuning), distila, combina, publica și vinde modelul și derivatele lui.
- Atribuirea este obligatorie. Orice produs care folosește modelul sau un derivat trebuie să afișeze vizibil „Built with Muse Spark Open”, în interfață, în documentație sau în setări. Prin „derivat”, licența înțelege și un model antrenat pe ieșirile lui Muse Spark Open.
- Pragul de 20 de milioane USD. O firmă care oferă terților acces la modele AI printr-un API (Model as a Service) și are, împreună cu afiliații, venituri de peste 20 de milioane USD în 12 luni, trebuie să încheie un acord separat cu Meta. Regula nu se aplică utilizării interne, cercetării și folosirii modelului ca o componentă a propriului produs.
- Meta nu revendică ieșirile modelului.
- Politica de utilizare interzice, printre altele, utilizările militare și nucleare, pe cele supuse reglementărilor ITAR și crearea de malware. Printre utilizările cu risc de vătămare, enumeră explicit operarea infrastructurii critice, a tehnologiilor de transport și a utilajelor grele. Pentru cine se gândește la un agent care comandă echipamente industriale, prevederea contează. Modelul nu este destinat persoanelor sub 18 ani.
Ce nu spune anunțul
- Costul hardware-ului. Anunțurile nu dau prețul configurației. Pe pagina Apple, memoria de 512 GB se poate comanda doar cu varianta de top a cipului M5 Ultra, cu CPU de 36 de nuclee și GPU de 80 de nuclee.
- Viteza la contexte mari și cu mai mulți utilizatori. Apple a măsurat doar la 8 192 și la 65 536 de tokeni, cu un singur utilizator. Pentru contextul de 1 milion de tokeni pe Mac nu există măsurători.
- Calitatea în NVFP4 și în cuantizările mai mici. Benchmarkurile nu precizează precizia folosită, iar pentru cuantizările de 2–3 biți nu există evaluări publicate.
- Raportul complet de siguranță. Meta spune că modelul a trecut pragurile cadrului său intern de evaluare a riscurilor, cu rezultatele detaliate pe pagina modelului, iar raportul complet va apărea „în curând”.
- Datele de antrenare. Nu sunt descrise în anunț și nici în blogurile tehnice. Nici data-limită a cunoștințelor nu apare în anunț; șablonul de chat din depozit o setează implicit la 4 ianuarie 2026.
- Raționamentul nu se poate opri. Detaliul apare în blogul Hugging Face, nu în anunț. Nivelul implicit este cel maxim, xhigh, iar pentru sarcini simple Hugging Face recomandă low, ca modelul să genereze mai puțini tokeni.
Ce merită reținut
- Un MoE ocupă memoria a 816 miliarde de parametri, dar are viteza unuia de 42 de miliarde. Capacitatea memoriei decide unde încape modelul, iar parametrii activi decid cât de repede generează.
- Pe Mac rulează versiunea pe 4 biți. NVFP4 ocupă circa 0,5 TB și cere două Mac Studio de 512 GB legate prin Thunderbolt 5. Cu 2–3 biți încape pe un singur Mac, cu o pierdere de calitate nepublicată.
- Estimează viteza din lățimea de bandă. Relația t = B/W dă o limită superioară. Măsurătorile Apple ating între o cincime și o treime din ea.
- Contextul mare se plătește la prefill. La 65 536 de tokeni, primul token vine după 40–70 s. Un milion de tokeni încărcați dintr-odată ar cere, după estimarea noastră, cel puțin 10–19 minute.
- Citește tot tabelul de benchmarkuri. Muse Spark Open conduce la agenți și cunoștințe, nu la programare, iar scorurile de cod depind și de unealta cu care a rulat fiecare model.
- Citește licența înainte de un produs. Atribuirea „Built with Muse Spark Open” este obligatorie, iar politica de utilizare exclude explicit operarea infrastructurii critice și a utilajelor grele.
Pentru cine învață machine learning, Muse Spark Open arată cum arhitectura (MoE), formatul numeric (NVFP4) și ierarhia de memorie decid împreună unde poate rula un model. Bazele sunt în cursul Machine Learning. Pentru ce înseamnă un context de 1 milion de tokeni la un model accesat prin API, cu prețuri per token, vezi articolul despre Gemini 4 Argon.